项目
这些模型、软件和数据集用于从固定答案中作出选择、帮助人工智能助手完成任务,以及识别被人工智能修改的人脸。每个项目都会注明哪些材料已经公开。
模型
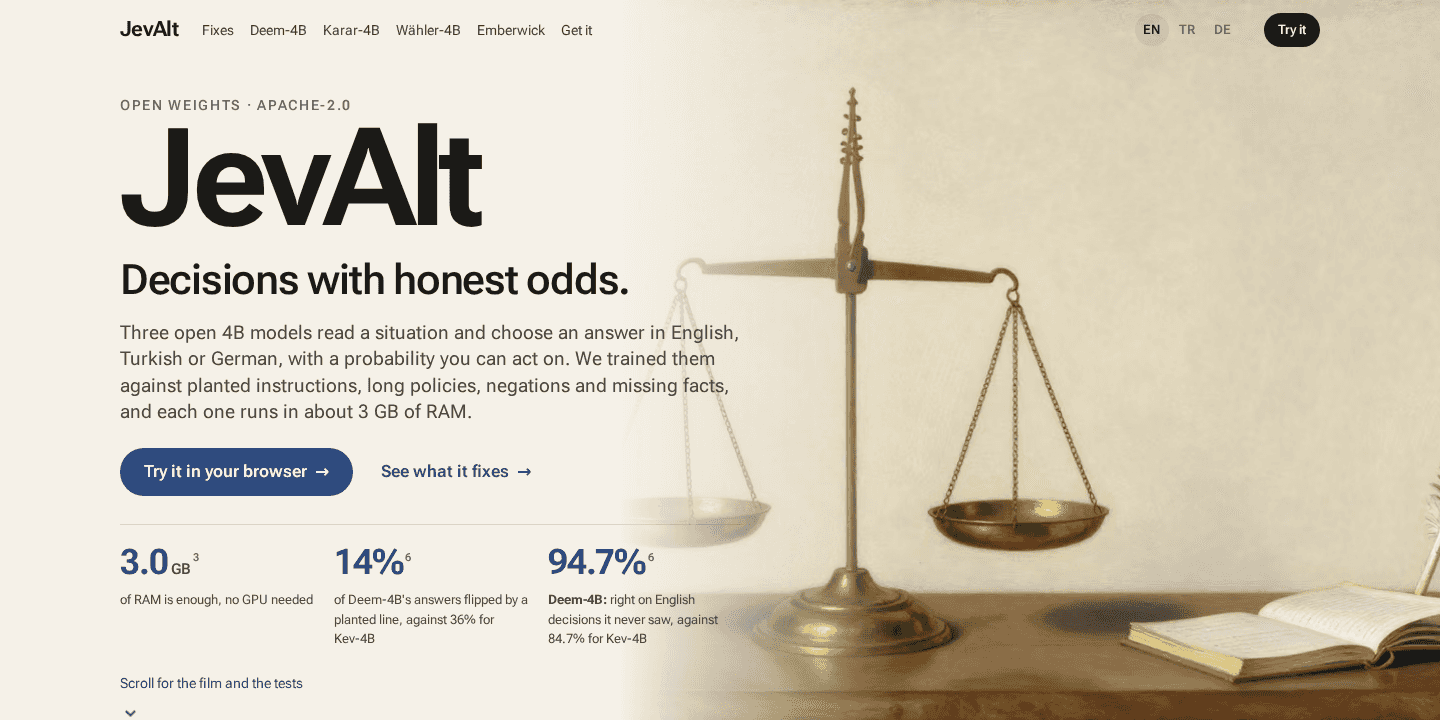
Deem-4B
Deem-4B 回答英语的固定选项问题,并估算每个答案的概率。
在未用于训练的 jevalt-bench 英语题目上,Deem-4B 的准确率为 94.7%,Kev-4B 为 84.7%。
Karar-4B
Karar-4B 回答土耳其语的固定选项问题,并估算每个答案的概率。
在未用于训练的 jevalt-bench 土耳其语题目上,Karar-4B 的准确率为 96.8%,Kev-4B 为 87.1%。
Wähler-4B
Wähler-4B 回答德语的固定选项问题,并估算每个答案的概率。
在未用于训练的 jevalt-bench 德语题目上,Wähler-4B 的准确率为 92.0%,Kev-4B 为 81.1%。
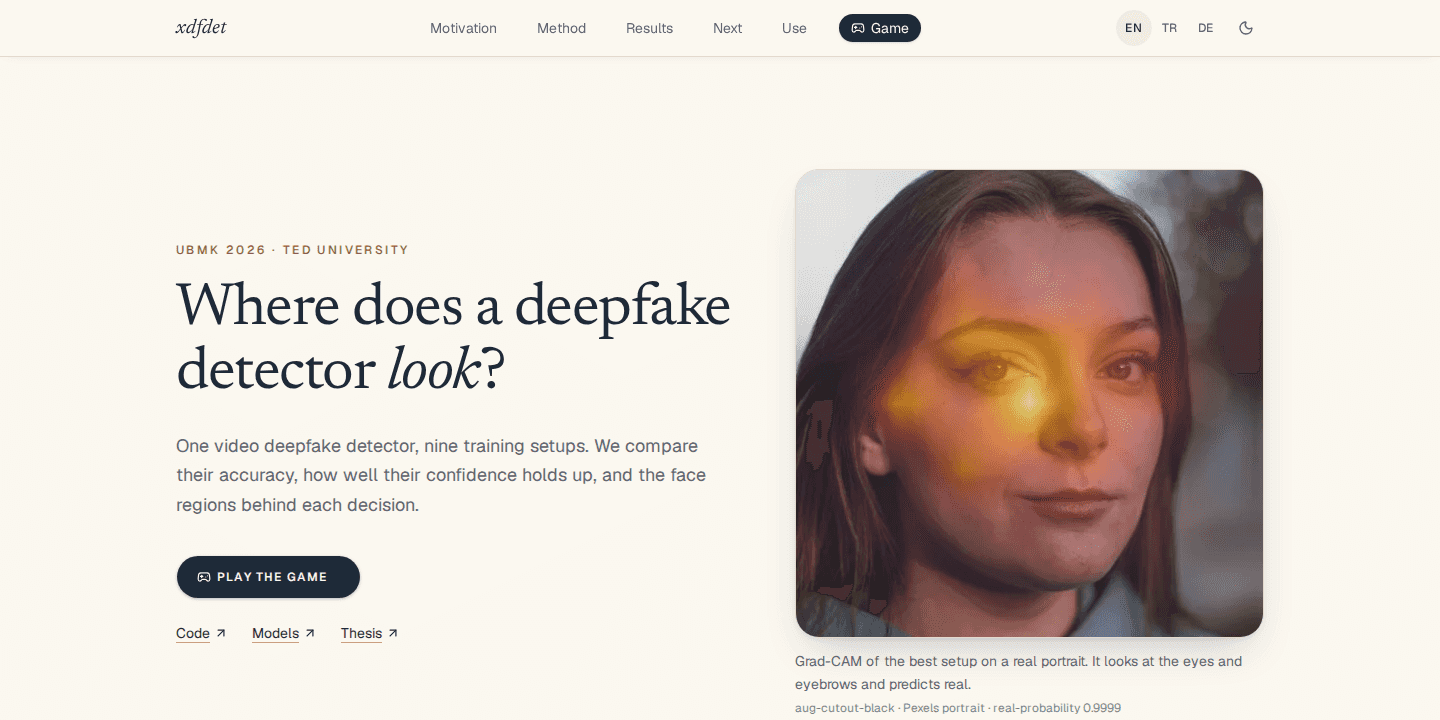
xdfdet
硕士论文中的八个训练好的检测器,并提供代码、热力图和两个浏览器游戏。相关论文已被 UBMK 2026 录用。
已发布八个模型。代码采用 MIT 许可证;训练好的模型文件采用 CC BY-NC 4.0,并遵守 FaceForensics++ 的条款。FaceForensics++ 是一个公开的真实与修改后人脸视频集。
Tholos-2B
Tholos-2B 是这些助手背后的小型模型,以 MiniCPM5-2B 为基础,使用已完成任务的操作记录进行训练。
Apache-2.0 许可证。
在同一张显卡(Kaggle T4)上,Tholos-2B 通过 160 项 Tholos-Bench 任务中的 137 项,MiniCPM5-2B 通过 112 项。在同一个普通中央处理器(CPU)上,Tholos-2B 通过 134 项,MiniCPM5-2B 通过 117 项。
论文
Augmentation and Cutout in Deepfake Detection: A Comparative Study of Accuracy, Calibration, and Attention
这篇已录用的论文比较九种深度伪造检测器训练方法,检查检测准确率、模型给出的概率与实际结果的吻合程度,以及模型依据哪些面部区域。
已被 UBMK 2026 接收。最终版本将收录于 IEEE Xplore,目前尚无 DOI。
Explainable deepfake detection using frame level CNN models: A comparative study of augmentation and cutout techniques
这篇硕士论文比较了多种训练方法,用于识别视频中经人工智能修改的人脸。热力图显示哪些面部区域影响了每项结果。
TED University 计算机科学硕士论文,2025 年。导师:Venera Adanova。
Language Preservation Using Agentic AI Architectures: A Tool-Grounded Small Language Model on a Constructed-Language Testbed
这篇论文研究 Eldalambë,一个面向托尔金虚构的精灵语 Quenya 和 Sindarin 的助手。采用的版本 Pro-Preserve 在 100 个测试请求中有 40 个写出预期句子,早期版本 Pro2508 为 21 个;Pro-Preserve 在 300 个案例中有 277 个正确识别托尔金的词,Pro2508 为 259 个。
公开预印本,未经同行评审。Eldalambë 的代码、数据、模型和基准测试均为私有。
开源软件
reevesagents
reevesagents 在同一个终端中并行运行多个人工智能编程助手,并由其中一个助手协调其他助手。
一个 npm 包,Apache-2.0 许可证,支持 10 种界面语言。
7,000npm 下载
截至
开放基准测试
数据集
早期项目
土耳其语诗歌生成器
这是为大学自然语言处理课程开发的深度学习模型,使用一组土耳其语诗歌训练。
成绩为 A。代码和论文均为私有。
AgriDL 智慧农业
AgriDL 是一款利用传感器数据和深度学习服务农业的移动应用,由政府合作方委托开发。
代码为私有。
基础设施
自托管生产平台
该平台运行公开项目、监控服务、发送警报并保存加密的异地备份。网络保护和配置均由代码定义。
私有。